Requêtes
Chargement d'une page et inspection des requêtes
En prenant un exemple sur un chargement de page https://www.gnu.org/philosophy/philosophy.html, nous allons voir comment fonctionne une requète HTTP en utilisant les outils d'inspection du navigateur : F12 > Network.
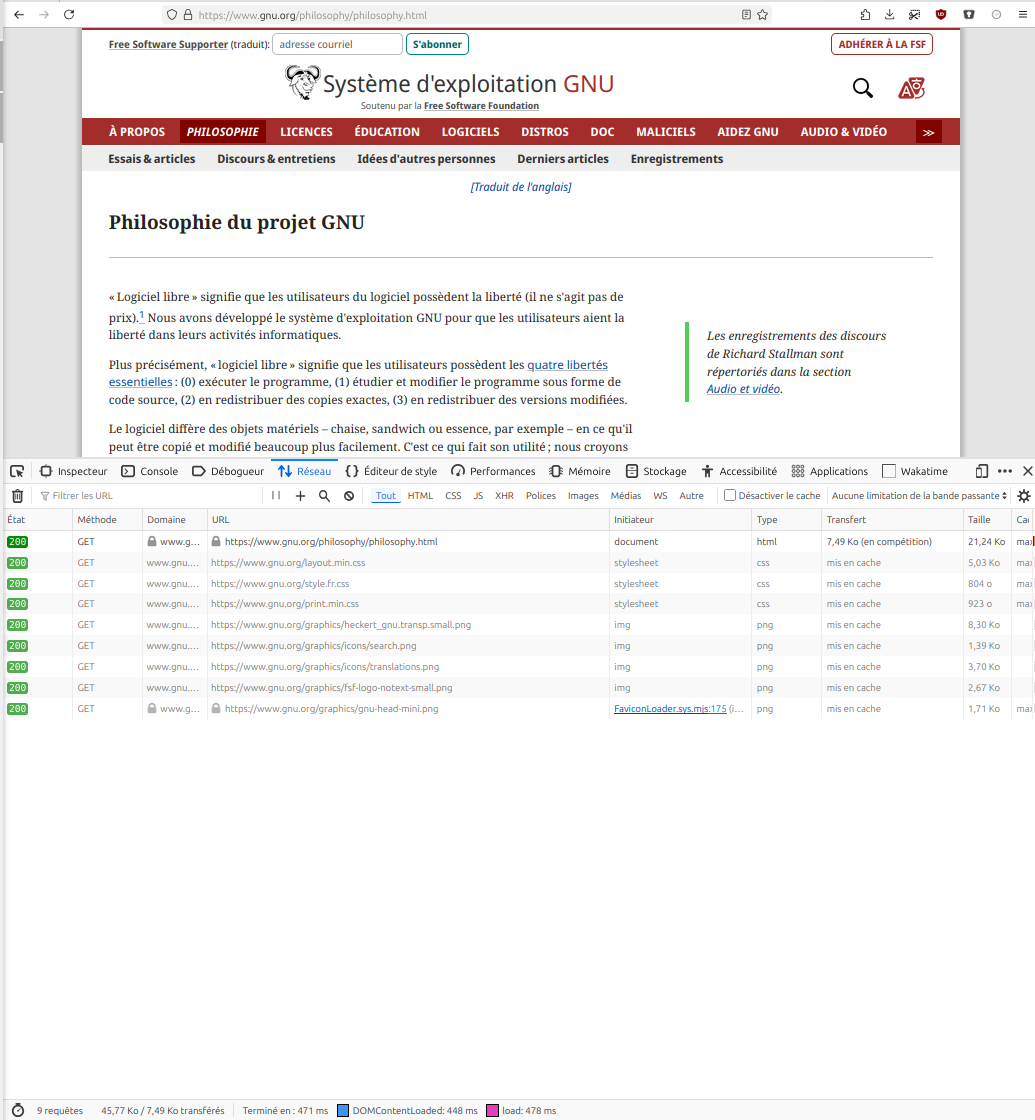
On peut observer que le chargement de cette page nécessite plusieurs requètes successives ou simultanées.
Observation d'une requète
Nous allons nous intéresser plus particulièrement à la première requète.
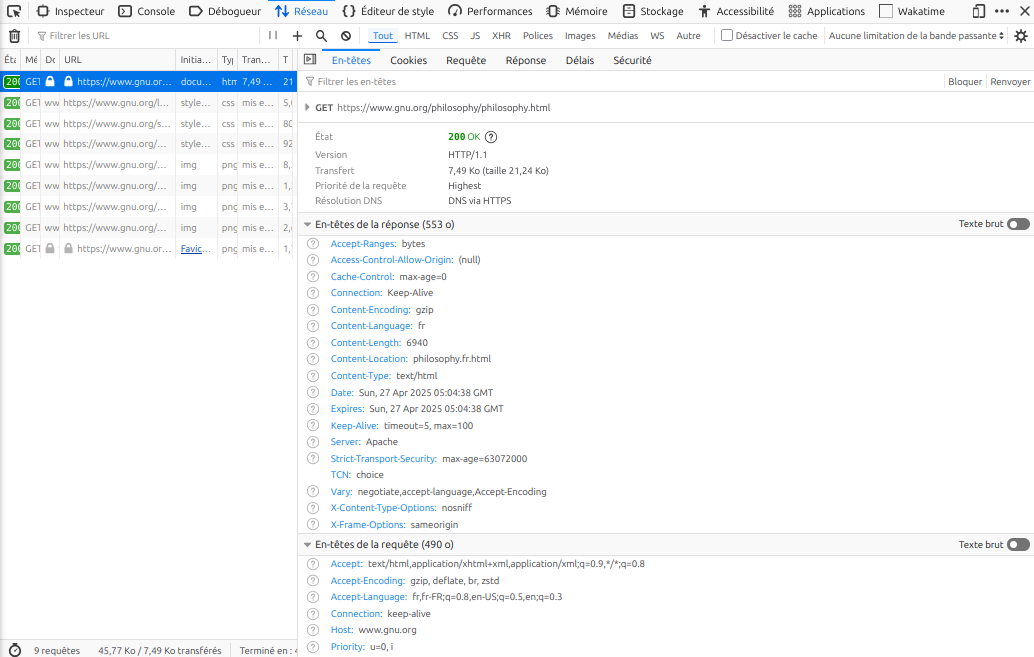
L'affichage indique à la fois la requète et la réponse.
Dans le protocole HTTP, la requète est faite sous forme d'un texte "spécial". Une première partie (jusqu'à la première ligne vide) constitue les en-têtes, et la deuxième partie constitue les données.
Cette première partie d'en-têtes est recopiées ci-dessous :
GET /philosophy/philosophy.html HTTP/1.1
Host: www.gnu.org
User-Agent: Mozilla/5.0 (X11; Ubuntu; Linux x86_64; rv:136.0) Gecko/20100101 Firefox/136.0
Accept: text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8
Accept-Language: fr,fr-FR;q=0.8,en-US;q=0.5,en;q=0.3
Accept-Encoding: gzip, deflate, br, zstd
Connection: keep-alive
Upgrade-Insecure-Requests: 1
Sec-Fetch-Dest: document
Sec-Fetch-Mode: navigate
Sec-Fetch-Site: none
Sec-Fetch-User: ?1
Priority: u=0, i
Première ligne
C'est une requète du client, qui part donc de notre navigateur, en direction de son destinataire. Mais à qui est envoyée cette requète ?
URL
Petit rappel sur les URL (vu précédemment):
l'URL https://www.gnu.org/philosophy/philosophy.html peut être décomposée en plusieurs partie :
https://indique le protocole (protocol), sécurisé ou non (le s), utilisé pour se connecter au sitewww.gnu.orgest le nom de domaine (hostname), que le DNS (Domain Name System) traduit en une adresse IP/philosophy/philosophy.htmlest le chemin (path / pathname)
Une url peut aussi contenir d'autres éléments : le port, une partie "search" ou "query string", un "hash"...
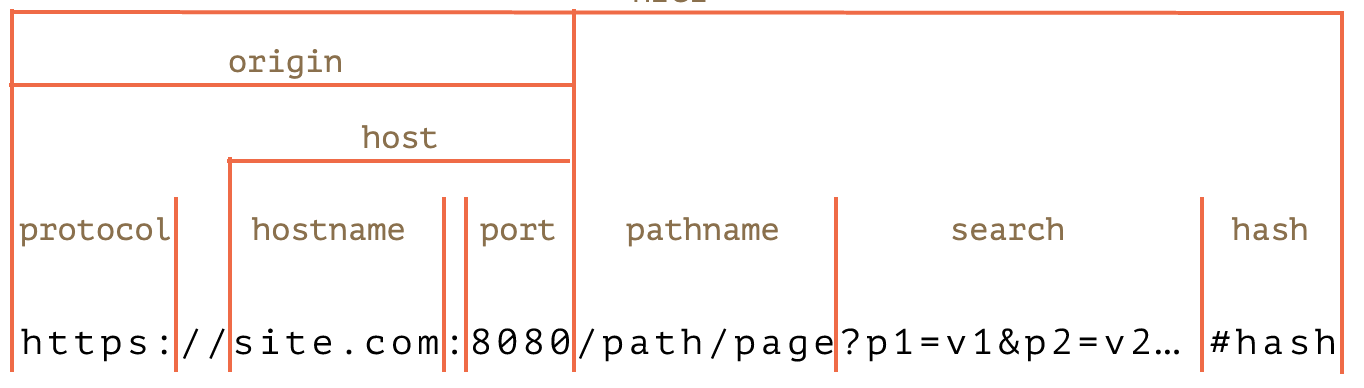
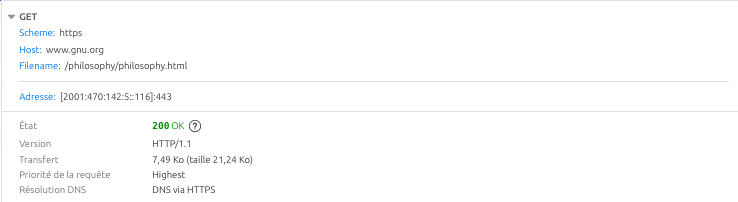
La requète est donc envoyé vers l'adresse IP correspondant au hostname, sur le port précisé dans l'url, et si aucun port n'est précisé (ce qui est le cas la plupart du temps), vers le port 80 pour le http et 443 pour le https.
Ici, la requète est donc envoyée vers l'IPv6 [2001:470:142:5::116] sur le port 443 (on peut le voir dans la partie General du détail) :
Addresse: [2001:470:142:5::116]:443
La première ligne de la requète :
GET /philosophy/philosophy.html HTTP/1.1
indique
- la méthode : GET
- le chemin (pathname) : /philosophy/philosophy.html
- le protocole utilisé et sa version (ici HTTP version 1.1)
Méthode
La méthode est en fait une commande spécifiant un type de requête, c'est-à-dire qu'elle demande au serveur d'effectuer une action sur la ressource indiquée juste ensuite. Les différentes méthodes disponibles sont GET, POST, HEAD, OPTIONS, DELETE, PATCH, PUT et plus rarement CONNECT et TRACE.
Une requète avec la méthode GET est une demande pour récupérer une ressource; de manière générale c'est une méthode qui doit correspondre à une opération idempotente (qui peut être répétée plusieurs fois sans que cela aie un effet)
En-têtes
D'autres informations sont transmises au serveur dans les en-têtes; toutes ces informations sont optionnelles, la seule obligatoire est cette première ligne.
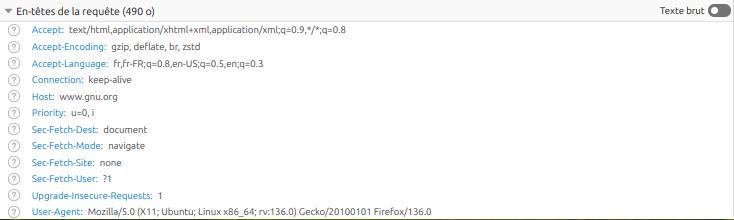
On peut reconnaître :
- Host : quel était l'hôte (nom de domaine et port) à qui la requête a été envoyé
- Accept : quel(s) types de document le navigateur accepte de recevoir en
réponse à cette requète, éventuellement avec un ordre de priorité (le
q=) - Accept-Encoding : le navigateur accepte (ou non) les données compressées
- Accept-Language : quelles sont la ou les langues préférées par l'utilisateur
de ce navigateur (avec un ordre de priorité donné par le
q=) - Cache-Control : indications pour garder ou non la réponse en "cache" (mémoire locale ou sur le réseau)
- User-Agent : une chaîne de caractères indiquant le système d'exploitation de la machine faisant tourner le navigateur, des infos sur le navigateur et sa version.
- ...